欢迎,来自IP地址为:216.73.216.105 的朋友
初次 接触数据分析时,我们可能会觉得它非常复杂,脑海中或许会浮现出庞大的数据库、高深的数学知识以及复杂的机器学习算法。
然而,许多实用的数据分析工作其实非常简单:加载数据集,针对数据提出问题,并利用 Python 寻找答案。
在本教程中,将使用 Python 和 pandas 构建一个简单的数据分析工具。我们将以一份虚构的学生表现数据集为例,学习如何加载数据、查看数据概况、计算统计指标、筛选记录、进行数据分组,以及创建基础的可视化图表。
完成本教程后,我们将掌握一套可复用的分析方法,能够应用于多种类型的 CSV 数据集。
前提条件
在开始本教程之前,需要具备一些基本的 Python 技能,并准备好相应的工具。虽然无需具备高级编程或数据分析经验,但应熟悉以下内容:
- Python 变量及基本数据类型(如字符串和数字)
- 如何导入库并调用函数
- 如何使用列表(list)以及执行基本的数据操作
如果是 Python 初学者,建议先掌握这些基础知识,再继续学习本教程。
此外,请确保已安装以下内容:
- Python:Python 3 或其他兼容的 Python 版本
- pandas:我们将使用此 Python 库来加载、筛选、分组和分析数据
- Matplotlib:我们将使用此库来创建数据可视化图表
- 代码编辑器或集成开发环境(IDE):例如 VS Code、PyCharm 或简单的文本编辑器,同时确保能够使用终端(Terminal)
我们可以在终端中运行以下命令来安装 pandas 和 Matplotlib:
# pip install pandas matplotlib
我们还需要一个文件夹,用来保存 Python 脚本以及我们在本教程中将要创建的”students.csv”数据集。
一切准备就绪后,现在就可以开始使用 Python 进行数据分析了!
环境配置
安装 pandas
如果尚未安装 pandas,可以打开终端并运行以下命令:
#pip install pandas matplotlib
我们将使用 pandas 进行数据分析,并使用 Matplotlib 进行简单的可视化。
安装完成后,可以通过以下代码验证安装是否成功:
import pandas as pd
import matplotlib.pyplot as plt

print(pd.__version__)
如果 Python 输出了 pandas 版本号,说明环境已准备就绪。
创建数据集
首先,我们将创建一个名为”students.csv”的文件,并向其中添加一些数据。
此处使用的数据集是虚构的,包含 12 条学生记录,涵盖了 9 至 12 年级。每一行代表一名学生,每一列则描述了学生的一项属性:
- name(姓名):学生的名字
- grade(年级):学生当前所在的年级
- study_hours(学习时长):学生的学习小时数
- attendance(出勤率):学生的出勤百分比
- score(成绩):学生的考试分数(满分 100 分)
例如,Ava 就读于 9 年级,学习时长为 4.5 小时,出勤率为 95%,考试成绩为 82 分。通过这些示例记录,我们可以探讨一些问题,例如学习时长是否与考试成绩相关,以及不同年级之间的平均成绩有何差异。
由于这些数据是虚构的且规模较小,我们观察到的任何规律仅供参考,不应将其视为针对全体学生的普遍结论。不过,这些数据足以让我们进行几项有意义的分析。
“students.csv”文件包含的数据如下:
name,grade,study_hours,attendance,score
Ava,9,4.5,95,82
Liam,9,6.0,98,91
Sophia,10,3.5,89,76
Noah,10,7.0,99,94
Emma,11,5.5,93,88
Oliver,11,8.0,97,96
Mia,12,4.0,91,79
Ethan,12,6.5,96,90
Isabella,9,7.5,100,97
Lucas,10,2.5,85,68
Amelia,11,6.0,94,92
James,12,5.0,90,84
使用 Pandas 加载数据集
使用 pandas 读取 CSV 文件,首先,导入 Pandas 库,开始我们的 Python 程序:
import pandas as pd
然后加载 CSV 文件:
data = pd.read_csv("students.csv")
“read_csv()”函数读取 CSV 文件并将其转换为 Pandas DataFrame。
DataFrame 是一种类似表格的数据结构,包含行和列。我们可以把它想象成一个可编程的电子表格。
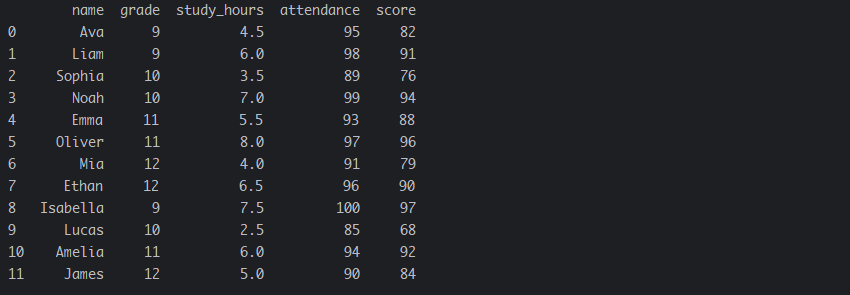
最后,我们显示数据集:
print(data)
不出意外的话,应该会在终端中看到打印出的学生记录。
浏览数据
在分析数据集之前,先了解一下我们所处理的数据是很有必要的。
查看前几行数据,”head()”方法会显示前五行数据:
print(data.head())
当然,我们还可以指定所需的行数:
print(data.head(3))
查看数据集大小
使用”shape”属性来获取数据集行数和列数:
print(data.shape)
(12, 5)
这意味着我们的数据集包含 12 行和 5 列。
查看列名
我们可以通过以下方式查看列名:
print(data.columns)
之后程序中如需要引用这些列时,这样做会很有用。
检查数据类型
使用 info() 函数来查看数据集各列的相关信息:
data.info()
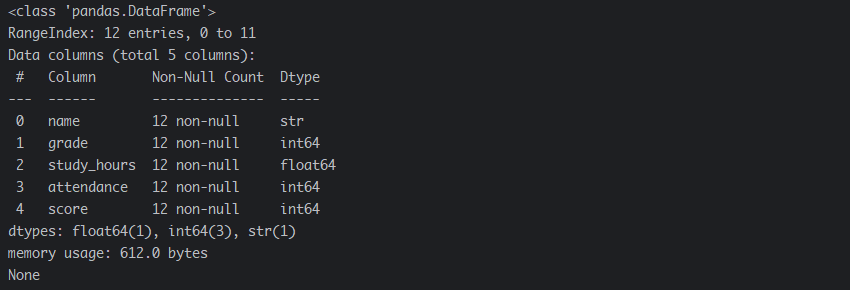
这有助于我们确定各列包含的是整数、小数、文本还是其他类型的数据。
计算基础统计量
使用 Pandas,无需手动编写数学公式,即可轻松计算统计量。
计算平均分
我们可以通过以下方式计算平均分:
average_score = data["score"].mean()
print(f"Average score: {average_score:.2f}")
其中,mean() 方法用于计算算术平均值。
“:.2f”格式化方式指示 Python 将结果显示为保留两位小数。
查找最高分和最低分
使用 max() 和 min():
highest_score = data["score"].max()
lowest_score = data["score"].min()

print(f"最高分:{highest_score}")
print(f"最低分:{lowest_score}")
同样,也可以求出中位数:
median_score = data["score"].median()
print(f"中位数:{median_score}")
注意中位数并不是按列的平均值,而是指将分数按顺序排列后位于中间的数值。
生成统计摘要
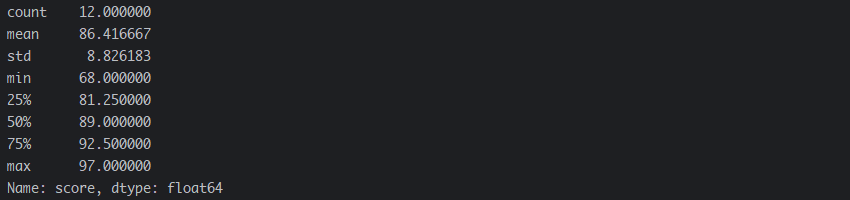
Pandas 还提供了一个便捷的 describe() 方法:
print(data["score"].describe())
这会生成如下统计数据:
- 计数
- 均值
- 标准差
- 最小值
- 25% 分位数
- 中位数
- 75% 分位数
- 最大值
示例输出如下:
当然,也可以针对所有数值列生成汇总信息:
print(data.describe())
在检测陌生数据集时,这往往是最先使用的命令之一。
数据筛选
pandas 最实用的功能之一,就是能够根据条件来选择行。
筛选高分学生
假设我们想要找出分数在 90 分及以上的学生:
high_scores = data[data["score"] >= 90]
print(high_scores)
其中,表达式”data[“score”] >= 90″会为每一行生成一个布尔条件。随后,Pandas 仅保留那些条件为”真”(True)的行。
我们还可以组合多个筛选条件,例如,假设我们想要找出学习时间超过五小时且出勤率高于 95% 的学生:
students = data[
    (data["study_hours"] > 5) &
    (data["attendance"] > 95)
    ]

print(students)
在 pandas 中组合条件时,使用 & 表示”与”(AND),使用 | 表示”或”(OR),且每个条件都应括在圆括号内。
查找特定学生
使用 idxmax()
有时,我们不仅想获取最大值,还想知道该最大值出现在哪条记录中。
例如:
top_student_index = data["score"].idxmax()
top_student = data.loc[top_student_index]

print(top_student)
idxmax() 会返回包含最大值的行的索引,而”.loc”属性会根据索引定位到数据集的具体行,这使我们能够将统计数据关联回原始记录。
数据分组
当数据集包含类别时,分组会特别有用。
在我们的数据集中,学生属于不同的年级。
各年级平均分
我们可以计算出每个年级的平均分:
average_by_grade = data.groupby("grade")["score"].mean()

print(average_by_grade)
分组生的结果就向我们展示了不同年级之间平均分的差异。
我们可以让输出结果更易于阅读:
average_by_grade = (
    data.groupby("grade")["score"]
    .mean()
    .round(2)
)

print(average_by_grade)
多项统计指标
我们可以同时计算多项统计指标:
grade_summary = data.groupby("grade")["score"].agg(
    ["mean", "min", "max", "count"]
).round(2)

print(grade_summary)
使用”agg”方法,会针对每个年级生成一份汇总,其中包含平均值、最小值、最大值以及学生人数。
分析学习时长
我们还可以探究学习时长与成绩之间的关系。
计算相关性
Pandas 提供了”corr()”方法:
correlation = data["study_hours"].corr(data["score"])

print(f"Correlation: {correlation:.2f}")
相关系数值通常在 -1 到 1 之间。
数值越接近 1,表明正向线性关系越强;数值越接近 -1,表明负向线性关系越强。数值接近 0 则表示线性关系很弱。
然而,相关性并不能证明一个变量会导致另一个变量。例如,如果该数据集中的学习时长与考试成绩存在相关性,这并不能证明学习时间更长直接导致了更高的成绩。
创建可视化图表
数字固然有用,但可视化图表能让人更容易识别出其中的规律。
创建散点图
我们将创建一个散点图,用以展示学习时长与考试成绩之间的关系:
import pandas as pd
import matplotlib.pyplot as plt

data = pd.read_csv("students.csv")
plt.scatter(data["study_hours"], data["score"])
plt.xlabel("Study Hours")
plt.ylabel("Test Score")
plt.title("Study Hours vs. Test Scores")

plt.show()
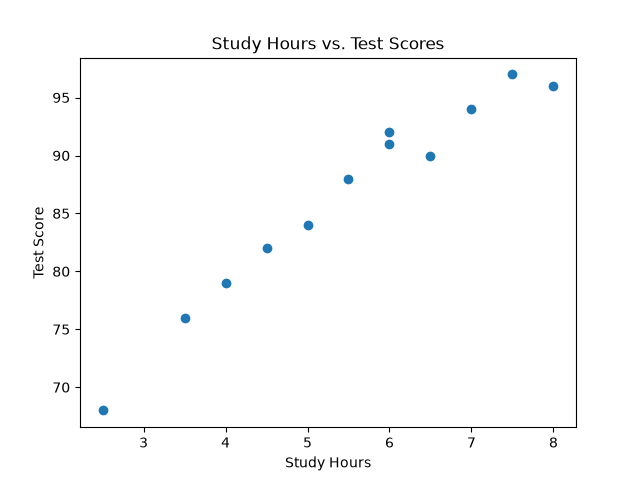
每个点代表一名学生。横轴代表学习时长,纵轴代表考试成绩。可以观察一下,随着学习时长的增加,这些点是否呈现出整体向上移动的趋势。
创建柱状图
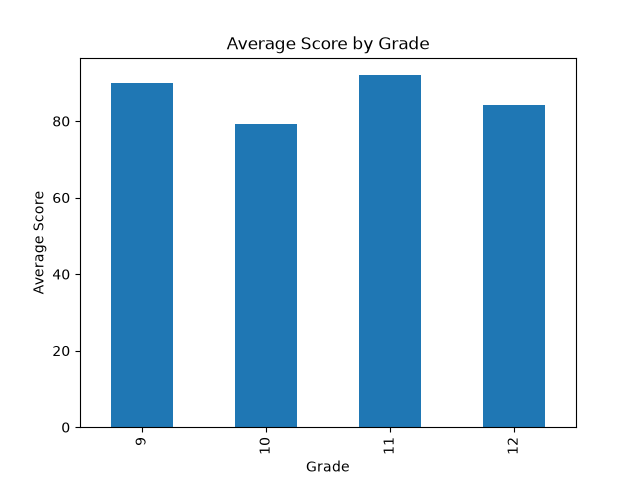
我们还可以将各年级的平均分进行可视化展示:
import pandas as pd
import matplotlib.pyplot as plt

data = pd.read_csv("students.csv")
average_by_grade = data.groupby("grade")["score"].mean()
average_by_grade.plot(kind="bar")
plt.xlabel("Grade")
plt.ylabel("Average Score")
plt.title("Average Score by Grade")

plt.show()
柱状图可以更方便地比较各组之间的平均值。
柱状图应呈现如下样式:
构建完整的分析器
现在,让我们将各项核心思路整合为一个程序。
import pandas as pd
import matplotlib.pyplot as plt

# Load the dataset
data = pd.read_csv("students.csv")

# Basic information
print("Dataset shape:")
print(data.shape)

print("\nFirst five rows:")
print(data.head())

# Score statistics
average_score = data["score"].mean()
median_score = data["score"].median()
highest_score = data["score"].max()
lowest_score = data["score"].min()

print("\nScore Statistics")
print(f"Average: {average_score:.2f}")
print(f"Median: {median_score:.2f}")
print(f"Highest: {highest_score}")
print(f"Lowest: {lowest_score}")

# Students with scores of 90 or higher
high_scores = data[data["score"] >= 90]

print("\nStudents with scores of 90 or higher:")
print(high_scores[["name", "score"]])

# Average score by grade
average_by_grade = (
    data.groupby("grade")["score"]
    .mean()
    .round(2)
)

print("\nAverage Score by Grade:")
print(average_by_grade)

# Study hours and score correlation
correlation = data["study_hours"].corr(data["score"])

print(f"\nStudy Hours vs. Score Correlation: {correlation:.2f}")

# Scatter plot
plt.scatter(data["study_hours"], data["score"])

plt.xlabel("Study Hours")
plt.ylabel("Test Score")
plt.title("Study Hours vs. Test Scores")

plt.show()
该程序现可执行一套规模虽小但完整的数据分析工作流程。
提升分析器的可复用性
接下来,一个有用的步骤是将重复执行的操作封装成函数。
创建分析函数
与其将所有代码直接写在主程序中,不如创建一个函数:
def analyze_scores(data):
    average = data["score"].mean()
    median = data["score"].median()
    highest = data["score"].max()
    lowest = data["score"].min()

    print(f"Average score: {average:.2f}")
    print(f"Median score: {median:.2f}")
    print(f"Highest score: {highest}")
    print(f"Lowest score: {lowest}")
然后,调用该函数进行数据分析:
import pandas as pd


def analyze_scores(data):
    average = data["score"].mean()
    median = data["score"].median()
    highest = data["score"].max()
    lowest = data["score"].min()

    print(f"Average score: {average:.2f}")
    print(f"Median score: {median:.2f}")
    print(f"Highest score: {highest}")
    print(f"Lowest score: {lowest}")


# Load the dataset
data = pd.read_csv("students.csv")
print(analyze_scores(data))
这使得代码更容易在另一个 DataFrame 中复用。
处理缺失数据
现实世界的数据集很少像我们的示例那样干净。我们有时可能会遇到缺失值。
可以使用以下方法检查缺失值:
print(data.isnull().sum())
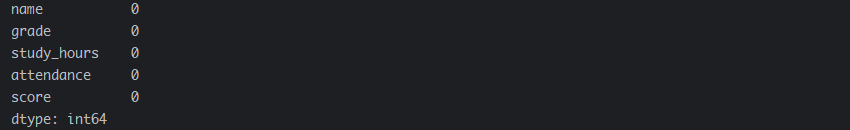
或者,根据数据集以及缺失值所代表的含义,我们也可以对缺失值进行替换:
data["score"] = data["score"].fillna(data["score"].mean())
上面的代码段是用平均分值来替换缺失值。显然不应将所有缺失值都自动替换为平均值。具体应采取何种处理方式,取决于缺失数据所代表的含义以及我们的分析目标。
导出结果
在分析数据集之后,我们可能希望保存分析结果。
例如:
import pandas as pd
import matplotlib.pyplot as plt

data = pd.read_csv("students.csv")
average_by_grade = (
    data.groupby("grade")["score"]
    .mean()
    .round(2)
)
average_by_grade.to_csv("average_scores_by_grade.csv")
我们也可以保存筛选后的记录:
import pandas as pd
import matplotlib.pyplot as plt

data = pd.read_csv("students.csv")
high_scores = data[data["score"] >= 90]
high_scores.to_csv("high_scoring_students.csv", index=False)
其中的”index=False”参数可防止 pandas 将 DataFrame 的索引作为额外的一列添加到文件中。
应避免的常见错误
忘记导入库,请确保已导入所需的库:
import pandas as pd
import matplotlib.pyplot as plt
否则,Python 将无法识别 pd 或 plt 的含义。
使用了错误的列名
列名必须与数据集中的名称一致。
例如,如果列名为”study_hours”,那么以下写法是行不通的:
“data[“study time”]”
我们可以随时通过以下代码查看实际的列名:
print(data.columns)
混淆相关性与因果关系
相关性可以揭示变量之间的关联,但并不能证明其中一个变量导致了另一个变量。
随着所处理的数据集变得越来越庞大、复杂,这种区分也愈发重要。
在充分了解数据之前进行分析
人们往往倾向于直接开始计算统计指标,但在此之前,请务必先审视一下数据集。
一些实用的初始命令包括:
- data.head()
- data.shape
- data.info()
- data.describe()
- data.isnull().sum()
了解数据的结构与质量,有助于避免得出错误的结论。
接下来最重要的一步,就是利用不同的数据集进行练习。一旦能够熟练地使用 pandas 来加载、探索、清洗和分析数据,便可以着手构建更为复杂的数据分析项目了。